Исследование и практика
Когда оценки AI вводят в заблуждение
Рост оценки может скрывать прежнюю ошибку. Как отделить качество агента, состав задач и критерии проверки перед бизнес-решением.
Опубликовано: Обновлено:
В этой статье
AI-агент поддержки получил более высокую оценку качества. Хочется сразу расширить его нагрузку. Но что улучшилось: сам агент, вопросы, которые ему задавали, или способ оценки ответов?
Это важно выяснить до того, как оценка станет основанием для бизнес-решения. За ростом показателя может последовать больше самостоятельности, расширение работы с клиентами или уверенность, что повторяющаяся проблема исправлена. Если условия сравнения изменились, решение опирается на подвижную шкалу.
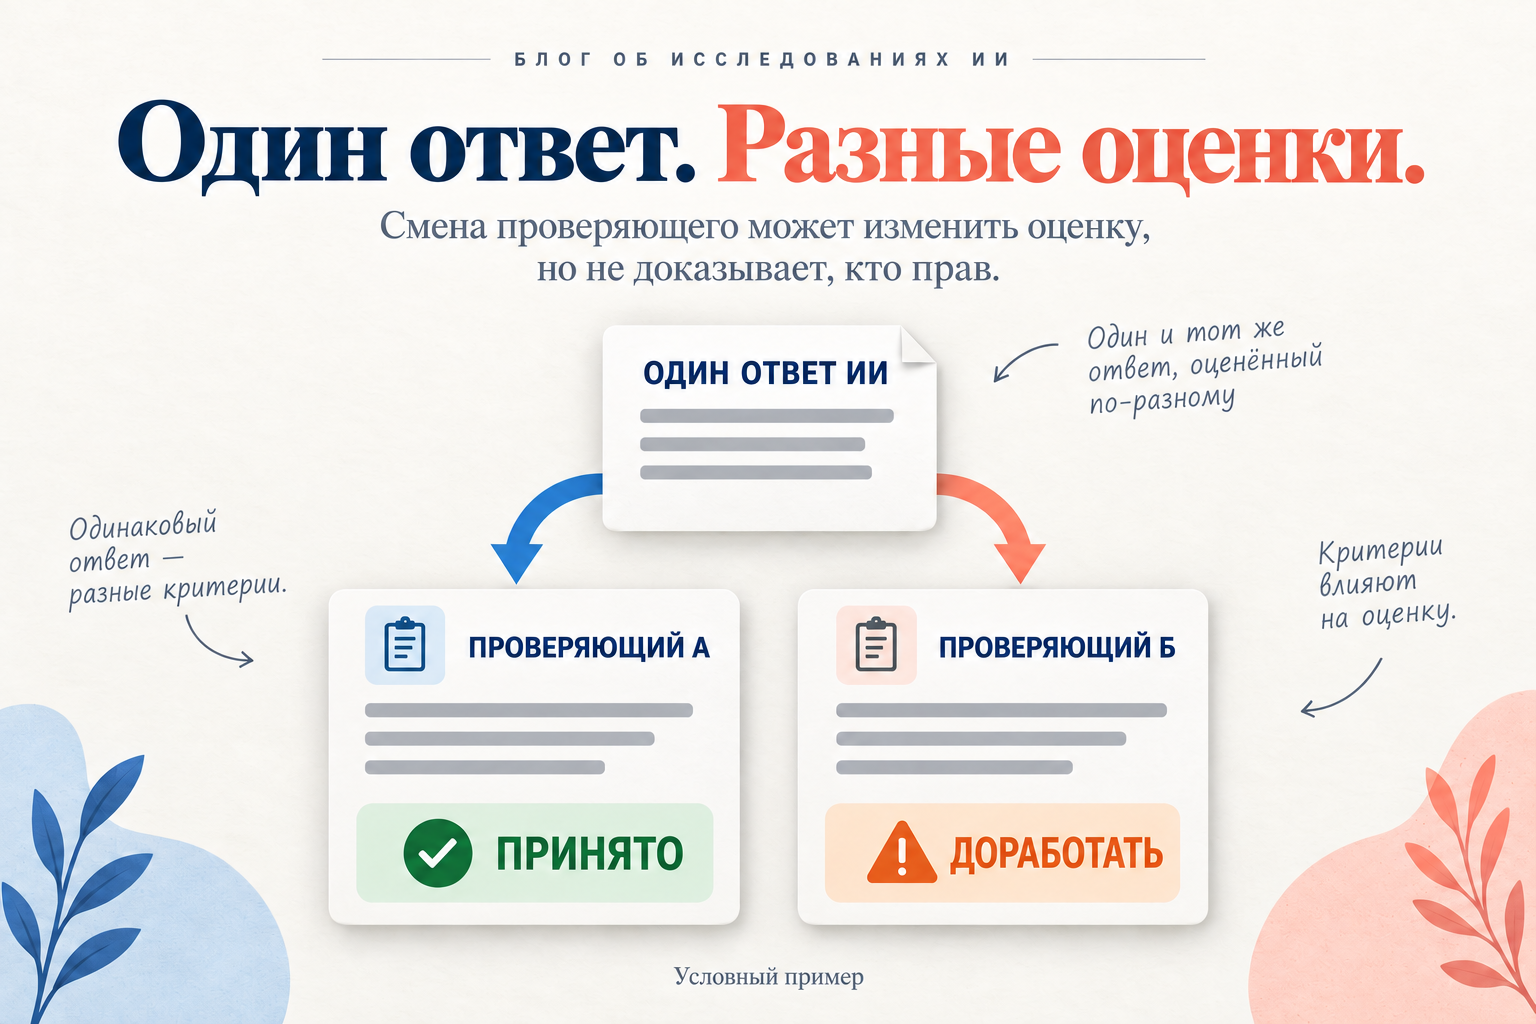
Оценивающий тоже влияет на результат измерения
В предварительной работе Liu Zhang и Mark Esposito, опубликованной 4 октября 2026 года, исследованы 2 611 оценённых интервью одного голосового и видеоагента. Несколько проверяющих оценивали пересекающиеся партии, что позволило отделить их строгость от изменений между партиями. Авторы обнаружили, что состав проверяющих скрывал динамику качества: учёт различий изменил её интерпретацию. Они также исследовали устаревание оценок и сопоставили динамику с операционным показателем. Это одно внедрение, а не универсальная оценка надёжности AI. Дизайн не доказывает, что именно оценивание вызвало улучшение. Исследование, версия 1.
Мой практический вывод: у оценки должно быть понятное происхождение. Какая версия системы выполнила работу? Какие случаи отобрали? По каким критериям и кем вынесен вердикт? Без этого у фразы «качество выросло» остаётся слишком много возможных объяснений.
Оценка выше, ошибка та же
Представим условный бизнес-пример. Это не эксперимент, который я проводила. AI-ассистент готовит ответы о продлении подписки. Клиент спрашивает, почему выросла сумма. Ассистент пишет ясно, соблюдает дружелюбный тон и ссылается на страницу тарифов. Но не замечает скидку в договоре этого клиента.
По критериям ясности такой ответ может получить высокую оценку. Проверка правильности суммы по договору должна его отклонить. Сами по себе эти оценки мало что объясняют, пока не определено, что требовалось бизнесу. Хороший текст ещё не решил вопрос клиента.
Теперь допустим, что во вторую проверку попало больше обычных продлений и меньше спорных скидок. Средняя оценка может вырасти даже при неизменных критериях, хотя на сложных случаях система не стала лучше. Полезное сравнение должно показывать эту разницу, а не прятать её в одном числе.
| Что могло измениться | Что сопоставить | Бизнес-вопрос |
|---|---|---|
| Агент или инструменты | Точную конфигурацию и доступные записи | Система стала способнее? |
| Состав случаев | Обычные продления и спорные условия | Задачи стали проще? |
| Оценивающий | Версию критериев и общие примеры | Изменился стандарт проверки? |
Сохранить сравнение, которое можно объяснить
При изменении процесса я бы сохраняла небольшой набор опорных случаев: обычное продление, противоречие в условиях договора, отсутствие записи и клиента, чья личность ещё не подтверждена. Это предлагаемый дизайн проверки, а не опубликованные результаты работы системы.
Старую и предлагаемую конфигурации нужно проверить на одних случаях. Сохранить входные данные, ответы, результаты инструментов и вердикты. Если критерии действительно требуется обновить, часть одних и тех же ответов следует оценить по обеим версиям. Разногласия останутся, но станут объяснимыми: можно указать изменившийся критерий вместо спора о непонятной средней оценке.
Опорный набор не должен определять всё качество. Система может лучше решать знакомые примеры и продолжать пропускать новые ситуации. Я бы отдельно сохраняла поступающие ошибки и решала, какие стоит включить в постоянные проверки после изменений. Тогда устойчивое сравнение сочетается с обучением на реальной работе.
Хороший ответ и выполненное действие проверяются по-разному
В инженерном руководстве Anthropic разделены история действий агента и итоговое состояние среды. Описаны проверки кодом, моделью и человеком. Для предпринимателя здесь полезен принцип: разным вопросам нужны разные доказательства. Оценка тона не заменяет проверку того, произошло ли нужное действие. Demystifying evals for AI agents.
В примере с подпиской я бы разделила три результата. Использован ли правильный договор? Понятно ли объяснена сумма? Если изменение было разрешено, записано ли правильное состояние продления в аккаунте? Эти проверки могут завершаться по-разному. Слишком раннее объединение лишает нас информации, необходимой для исправления процесса.
Это же различие помогает вовремя остановиться. Отсутствующий договор должен стать явно обозначенным нерешённым вопросом. Его не следует уверенно заменять публичной страницей тарифов. Для расследования это полезное промежуточное состояние, хотя вопрос клиента ещё не закрыт.
Решить, что изменится после обнаружения ошибки
Практическая ценность оценки ограничена, если каждая ошибка остаётся очередной записью на панели. До проверки я бы определила возможные действия: исправить источник, улучшить поиск, изменить интерфейс инструмента, сузить действие или добавить проверку перед следующим выпуском.
Например, «неправильная сумма продления» — это симптом. Если договор вообще не был найден, переписывание инструкции для ответа может оставить дефект нетронутым. Если правильный договор найден, но проигнорирован, расследование должно идти иначе. Доказательства должны позволять следующему агенту увидеть эту разницу без восстановления всей переписки.
Я бы закрывала проблему по конкретной версии и исходному неудачному примеру, затем проверяла близкие случаи. Успешное прохождение исправленного примера подтверждает исправление этого случая. Оно не доказывает правильность всех продлений. Это мой предлагаемый подход к работе, а не заявление, что я тестировала агента из исследования.
Когда обновлять доказательства
Одна дата не определяет полезность результата. Изменение модели, документов, состава клиентов или прав доступа может обесценить недавнюю проверку. И наоборот, узкий устойчивый расчёт может дольше оставаться сопоставимым. Я бы указывала явные поводы для повторной проверки: какое изменение требует заново проверить соответствующую часть?
Вопрос, на который я хочу получить ответ, конкретен: может ли эта версия выполнять этот тип задач в этих условиях? Если уверенности нет, следующий шаг должен назвать недостающее доказательство. Это полезнее высокой оценки, смысл которой никто не может объяснить.