Исследование и практика
Выбирайте AI-процесс, которым сможет пользоваться клиент
Начните с полезного отчёта о выручке, сравните целые системы и посчитайте стоимость пригодного для клиента результата.
Опубликовано: Обновлено:
В этой статье
Предположим, вы хотите предложить клиентам полезный ежемесячный отчёт о выручке. Агент должен соединить данные выставления счетов с клиентскими записями, объяснить изменения и подготовить удобный файл. Выбор модели с лучшим результатом бенчмарка решает только часть этой продуктовой задачи.
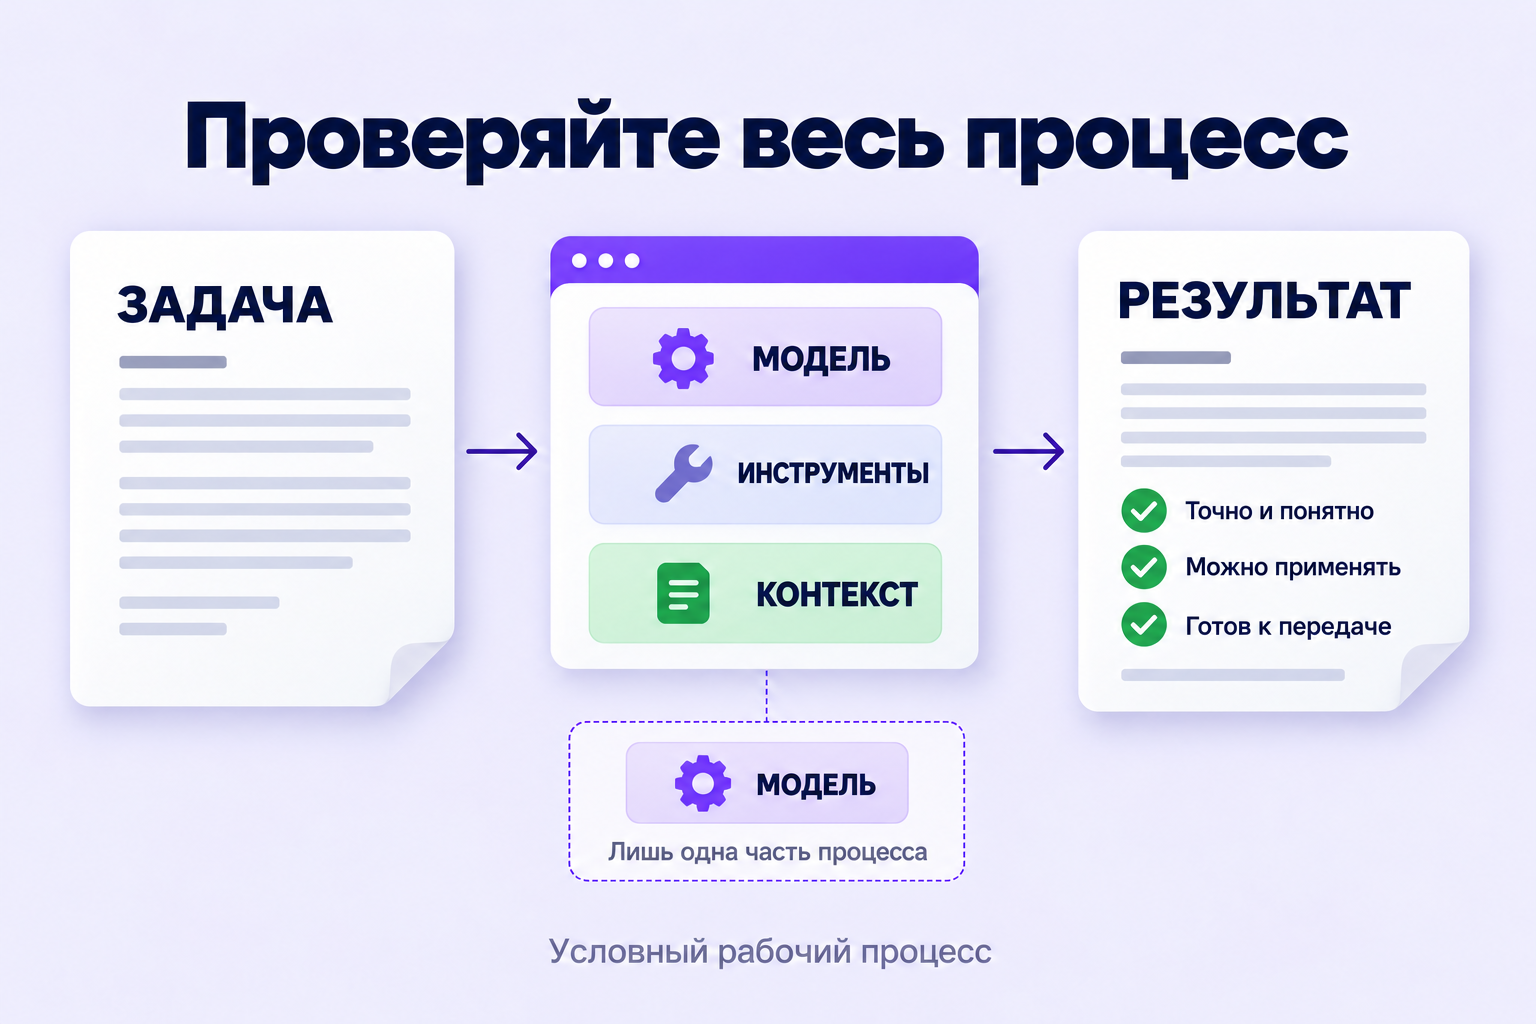
Модель будет работать внутри системы: доступ к документам, инструменты, расчёты, память, формат результата и продолжение работы при нехватке данных. Бизнес получает итог этого сочетания. Я бы выбирала систему по тому, что она способна регулярно выдавать на реальной задаче.
Почему сильная модель — ещё не весь продукт
Препринт AlphaEval, версия 1 от 14 апреля 2026 года оценивает агентные продукты на 94 задачах семи компаний. В таблице 3 одна модель получает разные баллы в разных продуктах. Это исторический снимок конфигураций, не текущий рейтинг. Экономические оценки работы не равны полученной клиентами экономии.
Одна модель — разные агентные продукты
Средний балл AlphaEval · Claude Opus 4.6 · шкала 0–100
В продуктовых решениях я бы разделяла возможности модели, возможности рабочего процесса и полезность итогового файла. Хороший ответ в чате не подтверждает, что система прочитала нужные документы, сохранила формулы или передала отчёт следующему процессу.
В этом есть и предпринимательская возможность. Бизнес может создать полезный продукт, соединив сильную модель с подходящим процессом. Ценность может находиться в переходе от разрозненных записей к понятному решению клиента, а не в создании новой языковой модели.
Определить отчёт, за который имеет смысл платить
Рассмотрим условный сервис отчётности по подписной выручке. В одной выгрузке — счета и корректировки, в другой — клиенты и изменения тарифов. Нужен календарный месяц. Клиент хочет понять, сколько выставлено, сколько оплачено и чем объясняется динамика.
Это разные показатели. Выставленный счёт не означает полученные деньги. Возврат может относиться к прежнему счёту. Изменение тарифа не обязательно действует весь месяц. Полезный отчёт определяет смысл показателей прежде, чем показывать уверенный итог.
Я бы задала небольшой законченный результат: сверенная рабочая таблица, короткое объяснение основных изменений и список неразрешённых записей. От каждого объяснения должен быть путь к исходным строкам. Расхождение нужно сохранить так, чтобы следующий процесс смог его исследовать, а не спрятать в гладком тексте.
| Вопрос клиента | Нужный результат | Полезная проверка |
|---|---|---|
| Что изменилось? | Раздельно показаны начисления, корректировки и поступления | Определения и границы периода соответствуют задаче |
| Откуда взялся итог? | Редактируемые расчёты связаны с исходными строками | Выбранную сумму можно воспроизвести |
| Что требует внимания? | Список несопоставленных записей и открытых вопросов | Недостающие данные сохранены и объяснены |
| Можно повторить через месяц? | Повторяемая структура входа и результата | Следующий период работает без пересборки всей задачи |
Это точнее, чем «проанализировать данные», но оставляет агенту возможность выбрать способ выполнения. Требования описывают ценность сервиса, не навязывая непроверенную реализацию.
Сравнить разные подходы на одной работе
Я бы сравнила несколько содержательно разных систем. Первая получает всю задачу как универсальный агент. Вторая соединяет детерминированное преобразование данных с моделью, объясняющей результат. Третья использует параллельных агентов для разных источников, объединяя выводы по одному периоду и определению клиента.
Для сравнения нужны одинаковый снимок данных и одинаковый результат. Иначе система с более чистым входом может выглядеть сильнее той, которая получила сложные документы. Я бы фиксировала модель, доступные инструменты и версию процесса, чтобы следующее изменение можно было сравнить с конкретной конфигурацией.
Нужна обычная задача, но нужны и правдоподобные исключения: корректировка без исходного счёта, дубликат строки или изменившийся идентификатор клиента. Это предлагаемые примеры проверки, не проведённые мной эксперименты. Они показывают, сможет ли продукт продолжать полезную работу за пределами аккуратной демонстрации.
Для стабильного извлечения может хватить небольшой модели с надёжным расчётным инструментом. Более сильный агент может оправдать стоимость при неоднозначном объяснении или незнакомой структуре документов. Я бы распределяла работу по результатам проверки, а не пропускала каждый шаг через одну дорогую модель.
Тратить на оценку там, где она улучшает продукт
Разделение выполнения и оценки помогает проверить такой выбор. Инженерный материал Anthropic от марта 2026 года описывает разработку приложений с агентами планирования, создания и оценки, явными критериями и обратной связью. Он также показывает дополнительную стоимость и задержку. Это конкретный инженерный подход, не требование собирать сложную систему для любой мелкой задачи.
В отчёте о выручке точные суммы и дубликаты естественно проверять вычислениями. Другой агент может исследовать необъяснённую динамику или оценить, отвечает ли текст на вопрос клиента. Параллельные проверки полезны, когда дают разные доказательства. Повторение одной расплывчатой оценки качества добавляет меньше.
Важна и возможность использовать результат. Правильные данные в неудобной таблице оставляют работу клиенту. Красивый PDF без расчётов не подходит тому, кому нужно продолжить анализ. Я бы оценивала корректность, полноту и удобство раздельно, прежде чем соединять их в итоговое решение.
Посчитать стоимость пригодного результата
Дешёвая генерация бывает дорогой поставкой. В условном сравнении запуск стоит £0,40, требует четырёх исправлений по £0,20 и финальной проверки за £0,10: вместе £1,30. Другой запуск стоит £0,90 плюс та же проверка: £1,00. Это арифметическая иллюстрация выбора, не измеренная производительность названных продуктов.
Из неё не следует, что дорогая модель всегда выгоднее. Повторно используемое преобразование данных может убрать большинство исправлений из первого процесса. А внутренней приблизительной оценке на пять минут может не требоваться ни один из этих вариантов. Считать нужно путь до пригодного результата и его сохранение при изменении входных данных.
Я бы начала с одного регулярного отчёта, обычного примера и небольшого набора реальных по смыслу исключений. Этого достаточно, чтобы выяснить, где основное ограничение: в модели, доступе к данным, процессе или самом определении продукта. Итогом должен стать более ясный предпринимательский выбор, а не ещё одна коллекция баллов AI.